本文主要是记录在Arm64架构的KickPi K2B开发板上,Sherpa-ONNX离线语音处理框架的部署与语音识别、语音合成、关键词唤醒模型的测试。
目前仅实现了利用官方部署好的静态库实现 离线语音转文字。
后续会实现语音合成、关键词识别
并且用其开发工具和C语言来实现demo
目录
目录核心概念说明所需资料下载1. 语音处理框架(Sherpa-ONNX)2. 核心模型下载语音识别(语音转文字)简单部署与测试1. 框架解压与目录说明2. 语音识别模型解压3. 关键参数与设备配置4. 语音识别执行命令语音合成(文字转语音)简单部署与测试1.前置准备(工具与模型校验)2. 核心操作:从设备配置到语音合成步骤 1:查询音频输出设备(关键!)步骤 2:执行语音合成命令3、结果验证:确认合成成功关键词检测(KWS)的完整部署与测试1. 前置准备:工具与模型校验2. 自定义关键词配置3. 核心操作:从设备配置到实时检测1. 检查ALSA库是否安装成功2. 检查libsamplerate库是否安装成功3. 确认Sherpa-ONNX头文件与库文件路径3.核心逻辑拆解:整个项目的运行逻辑代码参考(部分我已加注释)1. ALSA 音频设备驱动封装(录音核心)1. 编译器指定(嵌入式开发板默认gcc,交叉编译需改为aarch64-linux-gnu-gcc)2. 编译选项:-I指定头文件路径(需根据实际Sherpa-ONNX路径修改!)3. 链接选项:-L指定库路径,-l链接依赖库(需根据实际路径修改!)4. 生成可执行文件规则5. 生成.o目标文件规则6. 清理规则:删除.o文件和可执行文件6. Sherpa-ONNX 模型调用kws模型(推理核心)
核心概念说明
本次使用的是Sherpa-ONNX这一基于 ONNX 的离线语音处理框架,下面先理清几个核心概念,再详细说明在 KickPi K2B 开发板上的部署与测试流程。
- 大模型与推理引擎的关系:若把大模型比作电影,推理引擎就是播放器。两者相辅相成,缺少任何一方都无法实现语音处理功能,Sherpa-ONNX 在此扮演的就是推理引擎的角色。
- ONNX 格式:ONNX 是通用的大模型格式,除此之外,常见的大模型格式还有 PyTorch、TensorFlow 等,而 Sherpa-ONNX 正是依托 ONNX 运行时实现高效语音处理。
- Sherpa-ONNX 核心介绍Sherpa-ONNX 是基于 ONNX 运行时的开源语音处理库,设计理念是提供灵活、易用且高性能的语音处理解决方案,其核心特性如下:
- 多功能支持:涵盖语音识别、语音合成、说话人识别、语言识别、音频标签、语音活动检测(VAD)和关键词检测等多种语音任务。
- 跨平台兼容:可运行于 Windows、macOS、Linux 等桌面系统,也适配 Android、iOS 移动平台,同时支持 Raspberry Pi、RISC-V 架构等嵌入式设备,完美匹配 KickPi K2B 的 Arm64 架构。
- 多语言 API:提供 C++、C、Python 等十余种编程语言接口,本次实践选用 C 语言进行开发适配。
- 离线运行:无需网络连接即可工作,契合嵌入式场景对隐私和安全性的需求。
所需资料下载
本次开发针对 KickPi K2B(Arm64 架构),需下载框架程序库和对应语音模型,所有资源均来自 Sherpa-ONNX 官方 GitHub 仓库,具体清单如下:
1. 语音处理框架(Sherpa-ONNX)
从Sherpa-ONNX Github Releases下载适配 KickPi K2B(Arm64 架构)的预编译包,下载以下三个版本:
- 静态库版本(sherpa-onnx-v1.12.17-linux-aarch64-static.tar.bz2):打包所有依赖,无需额外系统库,适合测试场景。
- 指令集优化版本(sherpa-onnx-v1.12.17-linux-aarch64-jni.tar.bz2):支持 ARM NEON 指令集,推理速度更快,适配现代 Arm64 开发板。
- 动态链接版本(sherpa-onnx-v1.12.17-linux-aarch64-shared-cpu.tar.bz2):文件体积小,适合动态链接到其他程序,需依赖系统预装 C++ 运行库。包含的是
.so动态库和依赖动态库的可执行程序。
2. 核心模型下载
- 关键词检测(KWS)模型:sherpa-onnx-kws-zipformer-wenetspeech-3.3M-2024-01-01-mobile.tar.bz2,轻量化中文关键词检测模型,适配嵌入式场景。
- 语音识别(ASR)模型:sherpa-onnx-streaming-zipformer-small-bilingual-zh-en-2023-02-16.tar.bz2,中英双语流式模型,支持边说话边转文字。
- 文本转语音(TTS)模型:vits-icefall-zh-aishell3.tar.bz2,中文优化 VITS 架构模型,音质自然。
语音识别(语音转文字)简单部署与测试
1. 框架解压与目录说明
将下载的 Sherpa-ONNX 预编译包解压至开发板,进入解压后的
bin目录,可看到各类可执行文件(如sherpa-onnx-offline-tts用于文本转语音、sherpa-onnx-alsa用于对接音频设备的语音识别)。2. 语音识别模型解压
将下载的语音识别模型解压至开发板,进入解压后的目录,可看到
encoder/decoder/joiner的模型核心组件,还有tokens指定词汇表文件。这些东西都与后期在框架中的参数输入有关。3. 关键参数与设备配置
进入Sherpa框架的bin文件,核心就是使用
sherpa-onnx-alsa工具实现语音识别,首先需要直到麦克风设备,通过命令查看麦克风设备:输出结果中,例如我的 USB 麦克风对应设备号为
card 2,设备标识为hw:2,0(可能随重启变化,需重新查询确认)。4. 语音识别执行命令
在
bin目录下输入./sherpa - onnx - alsa可查看工具帮助文档
这里我的目录结构是这个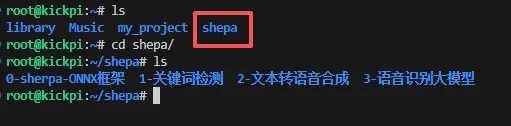
各核心参数说明如下:
参数 |
tokens |
encoder |
decoder |
joiner |
provider |
<td>指定推理硬件</td>
<td>因开发板硬件限制,此处选择
cpu</td></tr>
<tr>
</tr>
</tr>
</tr>
</tr>
</tr>
</tr>
</tr>
<td>num-threads</td>
<td>设置线程数</td>
<td>配置为 2,平衡性能与资源占用</td>
</tr>
<tr>
</tr>
</tr>
</tr>
</tr>
</tr>
</tr>
</tr>
<td>decoding-method</td>
<td>指定解码方式</td>
<td>选用
greedy_search(贪心搜索),兼顾效率与识别准确率</td></tr>
<tr>
</tr>
</tr>
</tr>
</tr>
</tr>
</tr>
</tr>
<td>device_name</td>
<td>指定音频输入设备</td>
<td>即麦克风设备标识,需通过指令查询确定例如我的参数为
hw:2,0</td></tr>
</table>
经过一系列的加载,当看到开始录音,请说话时,就代表成功了。
语音合成(文字转语音)简单部署与测试
语音合成(TTS)功能可将文本直接转换为可听语音,本次基于 Sherpa-ONNX 框架的 sherpa-onnx-offline-tts-play-alsa 工具实现 —— 该工具支持直接对接开发板音频输出设备,无需额外播放软件,适配嵌入式场景的轻量化需求。
1.前置准备(工具与模型校验)
在执行操作前,需先确认工具可用性与模型完整性,避免后续因文件缺失或路径错误导致失败。
1. 确认 TTS 工具位置
Sherpa-ONNX 预编译包的 bin 目录中包含多个 TTS 相关工具,核心工具及用途如下:
工具名称 | 核心功能 | 适用场景 |
sherpa-onnx-offline-tts | 仅将文本转换为 WAV 音频文件(需后续播放) | 需保存语音文件的场景 |
sherpa-onnx-offline-tts-play-alsa | 文本转语音后直接通过 ALSA 设备播放 | 实时听语音结果的测试场景 |
sherpa-onnx-offline-zeroshot-tts | 零样本 TTS(支持自定义发音人) | 需灵活切换发音风格的场景 |
本次选择
sherpa-onnx-offline-tts-play-alsa(实时播放),先通过以下命令确认工具可执行:在执行操作前,需先确认工具可用性与模型完整性,避免后续因文件缺失或路径错误导致失败。
2. 校验 TTS 模型文件完整性
需确保已下载的 TTS 模型(vits-icefall-zh-aishell3.tar.bz2)解压后,核心文件齐全。进入模型解压目录,应包含以下文件:
需存在的核心文件:
model.onnx:VITS 架构的核心合成模型(必选)
tokens.txt:文本字符映射表(定义模型可识别的汉字 / 符号,必选)
lexicon.txt:词典文件(将汉字映射为拼音,解决多音字问题,必选)
date.fst/number.fst等:文本预处理规则文件(处理日期、数字的发音,如 “2025” 读作 “二千零二十五年”,必选)
若缺少上述文件,需重新下载并解压模型包,避免因文件缺失导致合成失败。
2. 核心操作:从设备配置到语音合成
步骤 1:查询音频输出设备(关键!)
语音合成需指定开发板的 “音频播放设备”,通过
aplay -l 命令查询硬件设备列表:示例输出(需重点关注
card X 和 device Y):- 若连接耳机 / 音箱到开发板的 3.5mm 接口,通常对应
card 0(如示例中的audiocodec)
- 若通过 HDMI 输出音频,对应
card 1(ahubhdmi)
- 设备标识格式:
hw:X,Y(X=card 编号,Y=device 编号),示例中 3.5mm 接口对应hw:0,0
步骤 2:执行语音合成命令
在 Sherpa-ONNX 的
bin 目录下,执行以下命令(需根据自身路径和设备标识修改参数):关键参数详解(修正原表述误差,补充实操细节)
参数 | 核心作用 | 实操注意事项 |
--vits-model | 指定 VITS 架构的核心合成模型 | 路径必须完整,若提示 “File not found”,检查路径是否包含空格(需用引号包裹) |
--vits-tokens | 定义模型可识别的字符(汉字、标点等) | 不可省略,缺失会导致文本无法解析(如特殊符号可能被过滤) |
--vits-lexicon | 解决多音字问题(如 “行” 读 xíng 或 háng) | 若合成语音出现读音错误,可检查此文件是否包含对应汉字的拼音映射 |
--tts-rule-fsts | 处理特殊文本格式(日期、数字、符号) | 例如 “2025” 会被转换为 “二千零二十五年”,缺失会导致数字读作 “二零二五” |
<td>--vits-length-scale</td>
<td>控制语音速度</td>
<td>取值范围 0.1-3.0:0.5 = 快节奏,1.0 = 默认,1.5 = 慢节奏,根据需求调整</td>
</tr>
<tr>
</tr>
</tr>
</tr>
</tr>
</tr>
</tr>
<td>--sid</td>
<td>指定发音人(音色切换)</td>
<td>模型支持 0-174 共 175 个发音人:0 = 男性,100 = 中性女声,150 = 儿童声(可多试 ID)</td>
</tr>
<tr>
</tr>
</tr>
</tr>
</tr>
</tr>
</tr>
<td>--num-threads</td>
<td>分配的 CPU 线程数</td>
<td>KickPi K2B 建议 2-4 线程:线程过少会卡顿,过多会占用其他进程资源</td>
</tr>
<tr>
</tr>
</tr>
</tr>
</tr>
</tr>
</tr>
<td>--device</td>
<td>指定音频播放设备</td>
<td>必须与aplay -l查询的标识一致,否则无声音输出(常见错误:设备号填错)</td>
</tr>
</table>
3、结果验证:确认合成成功
执行命令后,通过以下现象判断是否成功:
- 无报错提示:命令行未出现 “Model load failed”“Device not found” 等错误
- 音频输出:连接的耳机 / 音箱能清晰听到文本对应的语音(如 “今天是 2025 年 11 月 18 日...”)
- 临时文件:工具会在内存中生成临时 WAV 文件(无需手动保存),播放完成后自动清理
若未听到声音,按以下顺序排查:
- 检查 --device 参数是否与 aplay -l 结果一致(如误填 hw:1,0 而实际用 3.5mm 接口)
- 确认耳机 / 音箱已通电且音量正常(可通过 aplay test.wav 播放测试音频验证设备)
- 检查模型文件是否完整(重新解压模型包,确认 model.onnx 大小是否正常,避免下载损坏)
关键词检测(KWS)的完整部署与测试
关键词检测(Keyword Spotting,简称 KWS)是语音交互系统的重要组成部分,能够在持续监听的同时,快速识别特定唤醒词(如 "小爱同学"、"你好军哥"),是实现语音助手、智能设备唤醒的核心技术。本次基于 Sherpa-ONNX 框架的sherpa-onnx-keyword-spotter-alsa工具,实现在 KickPi K2B 开发板上的实时关键词检测功能。
1. 前置准备:工具与模型校验
在执行关键词检测前,需先确认工具可用性与模型完整性,确保所有依赖文件正确配置。
1.1 确认关键词检测工具位置
Sherpa-ONNX 预编译包的bin目录中包含多个 KWS 相关工具,核心工具及用途如下:
工具名称 | 核心功能 | 适用场景 |
sherpa-onnx-keyword-spotter | 基础关键词检测工具(需手动输入音频文件) | 离线批量检测场景 |
sherpa-onnx-keyword-spotter-alsa | 对接 ALSA 音频设备的实时关键词检测 | 实时语音交互场景 |
sherpa-onnx-keyword-spotter-microphone | 通用麦克风接口的关键词检测 | 跨平台兼容性需求场景 |
本次选择
sherpa-onnx-keyword-spotter-alsa(实时 ALSA 设备支持),先通过以下命令确认工具可执行:若工具正常,将显示完整的参数说明文档。
1.2 校验 KWS 模型文件完整性
需确保已下载的 KWS 模型(sherpa-onnx-kws-zipformer-wenetspeech-3.3M-2024-01-01-mobile.tar.bz2)解压后,核心文件齐全。进入模型解压目录,应包含以下文件:
需存在的核心文件:
encoder-epoch-12-avg-2-chunk-16-left-64.onnx:编码器模型(处理音频特征提取)
decoder-epoch-12-avg-2-chunk-16-left-64.onnx:解码器模型(关键词匹配)
joiner-epoch-12-avg-2-chunk-16-left-64.int8.onnx:融合器模型(优化检测精度)
tokens.txt:词汇表文件(定义模型可识别的语音单元)
keywords.txt:关键词配置文件(定义需要检测的唤醒词)
keywords_raw.txt:原始关键词文件(备用参考)
1.3 关键词配置文件详解
keywords.txt是 KWS 功能的核心配置文件,定义了系统需要识别的关键词。文件格式采用 "拼音序列 @ 关键词文本" 的结构:
默认配置示例:
格式说明:
- 拼音部分:每个音节用空格分隔(如 "x iǎo ài t óng x ué" 对应 "小爱同学")
- @符号:分隔拼音序列和关键词文本
- 关键词文本:实际显示的唤醒词名称
2. 自定义关键词配置
根据实际需求,可以添加自定义关键词,扩展系统的唤醒词库。
2.1 添加自定义关键词
以添加 "小刘同学" 为例:
2.2 关键词配置原则
- 发音清晰:选择发音清晰、不易混淆的词汇
- 长度适中:建议 2-4 个汉字,过短易误触发,过长识别困难
- 独特性强:避免与常用词汇过于相似
- 拼音准确:确保拼音标注准确,特别是多音字
3. 核心操作:从设备配置到实时检测
3.1 查询音频输入设备
关键词检测需要指定麦克风设备,通过arecord -l命令查询:
arecord -l示例输出:
设备标识规则:
- USB 麦克风通常对应card 2(如示例中的 "USB Composite Device")
- 设备标识格式:hw:X,Y(X=card 编号,Y=device 编号)
- 示例中 USB 麦克风对应hw:2,0
3.2 执行关键词检测命令
在 Sherpa-ONNX 的bin目录下,执行以下完整命令:
--encoder="/root/shepa/1-关键词检测/sherpa-onnx-kws-zipformer-wenetspeech-3.3M-2024-01-01-mobile/encoder-epoch-12-avg-2-chunk-16-left-64.onnx" \
--decoder="/root/shepa/1-关键词检测/sherpa-onnx-kws-zipformer-wenetspeech-3.3M-2024-01-01-mobile/decoder-epoch-12-avg-2-chunk-16-left-64.onnx" \
--joiner="/root/shepa/1-关键词检测/sherpa-onnx-kws-zipformer-wenetspeech-3.3M-2024-01-01-mobile/joiner-epoch-12-avg-2-chunk-16-left-64.int8.onnx" \
--provider=cpu \
--num-threads=4 \
--keywords-file="/root/shepa/1-关键词检测/sherpa-onnx-kws-zipformer-wenetspeech-3.3M-2024-01-01-mobile/keywords.txt" \
--threshold=0.5 \
--min-active=0.5 \
hw:2,0
Recording started!Use recording device: hw:2,0
0:{"start_time":0.00, "keyword": "小爱同学", "timestamps": [1.00, 1.08, 1.20, 1.36, 1.40, 1.52, 1.60], "tokens":["x", "iǎo", "ài", "t", "óng", "x", "ué"]}
1:{"start_time":0.00, "keyword": "小艺小艺", "timestamps": [3.08, 3.20, 3.28, 3.36, 3.44, 3.52, 3.68, 3.72], "tokens":["x", "iǎo", "y", "ì", "x", "iǎo", "y", "ì"]}
2:{"start_time":0.00, "keyword": "你好军哥", "timestamps": [1.00, 1.04, 1.12, 1.16, 1.40, 1.44, 1.64, 1.72], "tokens":["n", "ǐ", "h", "ǎo", "j", "ūn", "g", "ē"]}
3:{"start_time":0.00, "keyword": "小刘同学", "timestamps": [2.92, 3.00, 3.12, 3.20, 3.32, 3.40, 3.56, 3.60], "tokens":["x", "iǎo", "l", "iú", "t", "óng", "x", "ué"]}
sudo apt install libsamplerate-dev
1. 检查ALSA库是否安装成功
pkg-config --modversion alsa # 输出版本号即正常(如1.2.6)
2. 检查libsamplerate库是否安装成功
pkg-config --modversion samplerate # 输出版本号即正常(如0.1.9)
3. 确认Sherpa-ONNX头文件与库文件路径
ls /root/shepa/0-sherpa-ONNX框架/sherpa-onnx-v1.12.17-linux-aarch64-shared-cpu/include # 应有sherpa-onnx目录
ls /root/shepa/0-sherpa-ONNX框架/sherpa-onnx-v1.12.17-linux-aarch64-shared-cpu/lib # 应有libsherpa-onnx-c-api.so
<td>文件名称</td>
<td>核心功能</td>
<td>对外接口</td>
<td>依赖模块</td>
</tr>
<tr>
</tr>
</tr>
</tr>
</tr>
<td>alsa.c/alsa.h</td>
<td>初始化录音设备、读取 PCM 数据、释放 ALSA 资源</td>
<td>init_alsa()、cleanup_alsa()</td>
<td>ALSA 库</td>
</tr>
<tr>
</tr>
</tr>
</tr>
</tr>
<td>resample.c/resample.h</td>
<td>音频格式转换(int16_t→float)、采样率重采样</td>
<td>init_resampler()、resample_audio()、cleanup_resampler()</td>
<td>libsamplerate</td>
</tr>
<tr>
</tr>
</tr>
</tr>
</tr>
<td>sherpa-asr.c/sherpa-asr.h</td>
<td>加载 ASR 模型、创建推理流、解码音频数据、清理模型</td>
<td>init_sherpa_asr()、
cleanup_sherpa_asr();</td>
<td>Sherpa-ONNX C API</td>
</tr>
<tr>
</tr>
</tr>
</tr>
</tr>
<td>main.c</td>
<td>串联三大模块(录音→重采样→推理)、处理信号退出</td>
<td>-</td>
<td>所有模块</td>
</tr>
<tr>
</tr>
</tr>
</tr>
</tr>
<td>Makefile</td>
<td>编译规则配置(指定头文件 / 库路径、链接依赖)</td>
<td>-</td>
<td>gcc 编译器</td>
</tr>
</table>
3.核心逻辑拆解:整个项目的运行逻辑
- 初始化ALSA(用于录音)、重采样器(用于将不同的采样频率转换为模型支持的16000HZ)、sherpa-onnx框架(用于运行模型)
- 程序不断麦克风读取int16_t 格式、单声道的 PCM 数据,采样率按照实际麦克风参数不定(我的为48000HZ)
- 数据输入到重采样器中,在采样器函数中,解决 “麦克风采样率≠模型要求采样率” 问题,同时将int16_t(ALSA 输出)转换为float(模型输入,范围 [-1.0, 1.0])。然后将处理好的数据存入开辟的堆内存空间中。
- 提交处理好的音频数据给sherp-onnx-C-API 加载的ASR模型等待并解码结果。
- 上述过程不断循环,直到模型说明已到达端点(可以理解为断句阈值,后续有提)程序输出语音转文字结果。
- 重置录音流、清除结果内存。。再开始新的一轮循环。
代码参考(部分我已加注释)
1. ALSA 音频设备驱动封装(录音核心)
alsa.c:
g_pcm_handle = NULL;
}
printf("ALSA资源清理完成n");
}
#ifndef ALSA_H
#define ALSA_H
#include <stdint.h>
#include <stdio.h>
#include <alsa/asoundlib.h>
// 录音设备配置
#define RECORD_DEVICE "hw:0,0" // 录音设备(根据实际情况调整)
#define RATE 16000 // ALSA请求采样率(硬件可能不支持,实际以actual_rate为准)
#define PERIOD_SIZE 1024 // 录音缓冲区周期大小(单次读取样本数)
#define CHANNELS 1 // 单声道(与模型一致)
// 全局PCM句柄(供ALSA初始化和重采样使用)
extern snd_pcm_t *g_pcm_handle;
// 实际采样率(由ALSA初始化后设置)
extern unsigned int g_actual_rate;
// 语音识别模型配置(模型的目标采样率,需根据sherpa模型实际参数调整!)
#define MODEL_SAMPLE_RATE 16000 // sherpa-asr模型采样率为16000Hz
// ALSA相关函数声明
int init_alsa(void);
void cleanup_alsa(void);
#endif
#include "mysamplerate.h"
// 重采样全局状态(仅当前文件可见)
static SRC_STATE *src_state = NULL; // libsamplerate状态句柄
static float *src_output_buf = NULL; // 重采样输出缓冲区(float格式,供模型使用)
static const int MAX_OUTPUT_FRAMES = PERIOD_SIZE * 3; // 输出缓冲区最大容量(应对采样率升高)
static double resample_ratio = 0.0; // 保存重采样比率
// 初始化重采样器(核心)
int init_resampler(void)
{
// 校验1:g_actual_rate是否有效(必须为正数)
if (g_actual_rate <= 0) {
fprintf(stderr, "[ERROR] 重采样初始化失败:g_actual_rate无效(%u),请检查ALSA初始化n", g_actual_rate);
return -1;
}
// 校验2:模型采样率是否有效
if (MODEL_SAMPLE_RATE <= 0) {
fprintf(stderr, "[ERROR] 重采样初始化失败:MODEL_SAMPLE_RATE无效(%d)n", MODEL_SAMPLE_RATE);
return -1;
}
// 校验3:声道数是否有效
if (CHANNELS != 1) {
fprintf(stderr, "[WARNING] 当前仅支持单声道!请确保ALSA配置为单声道(CHANNELS=%d)n", CHANNELS);
// 若需支持多声道,需修改重采样和数据处理逻辑(如平均合并为单声道)
return -1;
}
// 计算重采样比率(输出采样率/输入采样率)
resample_ratio = (double)MODEL_SAMPLE_RATE / g_actual_rate; // 修改:使用全局变量存储
// 校验4:比率是否在libsamplerate允许范围
if (resample_ratio < (1.0 / 256.0) || resample_ratio > 256.0) {
fprintf(stderr, "[ERROR] 重采样比率超出范围!允许范围[1/256, 256],当前:%.4f(MODEL=%d, ACTUAL=%u)n",
resample_ratio, MODEL_SAMPLE_RATE, g_actual_rate);
return -1;
}
int error = 0;
// 1. 创建重采样器(单声道,速度优先模式,适合实时场景)
src_state = src_new(SRC_SINC_FASTEST, CHANNELS, &error);
if (src_state == NULL) {
fprintf(stderr, "[ERROR] 初始化重采样器失败: %sn", src_strerror(error));
return -1;
}
// 2. 设置固定重采样比率
if (src_set_ratio(src_state, resample_ratio) != 0) {
fprintf(stderr, "[ERROR] 设置重采样比率失败n");
src_delete(src_state);
src_state = NULL;
return -1;
}
// 3. 分配重采样输出缓冲区(堆上分配,避免栈溢出)
src_output_buf = (float )malloc(MAX_OUTPUT_FRAMES sizeof(float));
if (src_output_buf == NULL) {
fprintf(stderr, "[ERROR] 分配重采样输出缓冲区失败(内存不足)n");
src_delete(src_state);
src_state = NULL;
return -1;
}
printf("重采样器初始化成功:输入率=%u Hz → 输出率=%d Hz,比率=%.4f,声道数=%dn",
g_actual_rate, MODEL_SAMPLE_RATE, resample_ratio, CHANNELS);
return 0;
}
// 重采样核心函数:int16_t(ALSA)→ float(归一化+重采样)→ 供模型使用
int resample_audio(const int16_t input, int input_frames, float output, int output_frames)
{
// 参数合法性校验
if (src_state == NULL || input == NULL || output == NULL || output_frames == NULL) {
fprintf(stderr, "[ERROR] 重采样参数无效(空指针或未初始化)n");
return -EINVAL;
}
if (input_frames <= 0) {
fprintf(stderr, "[WARNING] 重采样输入帧数为0n");
*output_frames = 0;
return 0;
}
// 1. 分配输入缓冲区(堆上分配,避免栈溢出!用完立即释放)
float src_input_buf = (float )malloc(input_frames CHANNELS sizeof(float));
if (src_input_buf == NULL) {
fprintf(stderr, "[ERROR] 分配重采样输入缓冲区失败(内存不足)n");
return -ENOMEM;
}
// 2. int16_t → float归一化(范围[-1.0, 1.0])
for (int i = 0; i < input_frames * CHANNELS; i++) {
src_input_buf[i] = (float)input[i] / 32768.0f; // 16位有符号整数最大值32767,除以32768确保不溢出
}
// 3. 配置重采样参数
SRC_DATA src_data = {0};
src_data.data_in = src_input_buf; // 输入float缓冲区(归一化后)
src_data.data_out = src_output_buf; // 输出float缓冲区(重采样后)
src_data.input_frames = input_frames; // 输入帧数(每帧含CHANNELS个样本)
src_data.output_frames = MAX_OUTPUT_FRAMES;// 输出缓冲区最大帧数
src_data.end_of_input = 0; // 流式处理,非结束帧
src_data.src_ratio = resample_ratio; // 显式设置重采样比率
// 4. 执行重采样
int error = src_process(src_state, &src_data);
if (error != 0) {
fprintf(stderr, "[ERROR] 重采样失败: %s(输入帧数=%d,比率=%.4f)n",
src_strerror(error), input_frames, src_data.src_ratio);
free(src_input_buf);
return -1;
}
// 5. 返回结果
*output = src_output_buf;
*output_frames = src_data.output_frames_gen; // 实际生成的输出帧数
// 释放临时输入缓冲区(堆上分配,必须手动释放)
free(src_input_buf);
// 调试信息(可选关闭)
// printf("[DEBUG] 重采样:输入帧数=%d → 输出帧数=%dn", input_frames, *output_frames);
return 0;
}
// 清理重采样资源
void cleanup_resampler(void)
{
if (src_state != NULL) {
src_delete(src_state);
src_state = NULL;
}
if (src_output_buf != NULL) {
free(src_output_buf);
src_output_buf = NULL;
}
printf("重采样器资源清理完成n");
}
#ifndef MYSAMPLERATE_H
#define MYSAMPLERATE_H
#include <samplerate.h>
#include <stdint.h>
#include "alsa.h"
// 1. 初始化重采样器(需在ALSA初始化后调用,因依赖g_actual_rate)
int init_resampler(void);
// 2. 核心重采样函数:将ALSA的int16_t数据转换为模型所需的float数据
// input:ALSA读取的int16_t原始数据
// input_frames:输入数据帧数
// output:输出float格式数据的指针(模块内分配,外部无需释放)
// output_frames:输出数据帧数(返回值)
int resample_audio(const int16_t input, int input_frames, float output, int output_frames);
// 3. 清理重采样资源(释放缓冲区和重采样器句柄)
void cleanup_resampler(void);
#endif
#include "sherpa-asr.h"
// 全局音频流指针
const SherpaOnnxOnlineStream *g_asr_stream = NULL;
// 全局识别器指针
const SherpaOnnxOnlineRecognizer *g_asr_recognizer = NULL;
int init_sherpa_asr(void)
{
/*
写代码时,可以去Github的sherpa-onnx目录下的c-api-examples目录查看c-api-alsa.c的示例代码
示例代码中包含了初始化语音识别模型的代码
*/
// 初始化语音识别模型的配置
SherpaOnnxOnlineRecognizerConfig config = {0};
// 配置语音识别模型的参数
config.feat_config.sample_rate = RATE; // 模型的采样率
config.feat_config.feature_dim = 80; // 梅尔频谱特征维度
// 配置语音识别模型的参数
config.model_config.transducer.decoder = "/root/shepa/3-语音识别大模型/sherpa-onnx-streaming-zipformer-small-bilingual-zh-en-2023-02-16/decoder-epoch-99-avg-1.onnx";
config.model_config.transducer.encoder = "/root/shepa/3-语音识别大模型/sherpa-onnx-streaming-zipformer-small-bilingual-zh-en-2023-02-16/encoder-epoch-99-avg-1.onnx";
config.model_config.transducer.joiner = "/root/shepa/3-语音识别大模型/sherpa-onnx-streaming-zipformer-small-bilingual-zh-en-2023-02-16/joiner-epoch-99-avg-1.onnx";
config.model_config.tokens = "/root/shepa/3-语音识别大模型/sherpa-onnx-streaming-zipformer-small-bilingual-zh-en-2023-02-16/tokens.txt";
config.model_config.num_threads = 4; // 线程数
config.model_config.provider = "cpu"; // 提供器,这里选择CPU
config.model_config.debug = 0; // 不开启调试模式
config.max_active_paths = 4; // 最大活动路径数(多个权重,每个权重对应一个路径)
config.decoding_method = "greedy_search"; // 解码方法: 贪婪搜索
config.enable_endpoint = 1; // 开启端点检测(用于检测语音结束)
config.rule1_min_trailing_silence = 0.8; // 规则1: 最小尾端静音时间(秒)
config.rule2_min_trailing_silence = 0.6; // 规则2: 最小尾端静音时间(秒)
config.rule3_min_utterance_length = 500; // 规则3: 毫秒,最小语音长度(用于去除噪音)
// 创建识别器
g_asr_recognizer = SherpaOnnxCreateOnlineRecognizer(&config);
if(!g_asr_recognizer)
{
fprintf(stderr, "[ERROR] 创建识别器失败!n");
return -1;
}
// 创建音频流
g_asr_stream = SherpaOnnxCreateOnlineStream(g_asr_recognizer);
if(!g_asr_stream)
{
fprintf(stderr, "[ERROR] 创建音频流失败!n");
return -1;
}
return 0;
}
// 清理sherpa-onnx资源
void cleanup_sherpa_asr(void)
{
if (g_asr_stream != NULL) {
SherpaOnnxDestroyOnlineStream(g_asr_stream);
g_asr_stream = NULL;
}
if (g_asr_recognizer != NULL) {
SherpaOnnxDestroyOnlineRecognizer(g_asr_recognizer);
g_asr_recognizer = NULL;
}
printf("ASR模型资源清理完成n");
}
#ifndef SHERPA_ASR_H
#define SHERPA_ASR_H
#include <stdio.h>
#include "sherpa-onnx/c-api/c-api.h" // Sherpa-ONNX C API头文件
#include "alsa.h" // 复用模型采样率配置
// 1. 全局推理资源(供main.c提交音频和获取结果)
extern const SherpaOnnxOnlineStream *g_asr_stream; // 音频流(存储音频数据)
extern const SherpaOnnxOnlineRecognizer *g_asr_recognizer; // 识别器(执行推理)
// 2. 初始化Sherpa-ONNX:加载模型、创建识别器和音频流
int init_sherpa_asr(void);
// 3. 清理Sherpa-ONNX资源:释放音频流和识别器
void cleanup_sherpa_asr(void);
#endif
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <errno.h>
#include <signal.h> // 用于捕获退出信号
#include "alsa.h"
#include "sherpa-asr.h"
#include "sherpa-onnx/c-api/c-api.h"
#include "mysamplerate.h"
// 全局运行标志
int running = 1;
// 信号处理函数:捕获Ctrl+C,优雅退出~~
void sigint_handler(int sig) {
printf("n收到退出信号,正在清理资源...n");
running = 0;
}
// 主函数(整合ALSA+重采样+ASR)
int main(int argc, char const *argv[])
{
// 注册信号处理函数(捕获Ctrl+C)
signal(SIGINT, sigint_handler);
printf("=== 语音识别系统启动 ===n");
printf("配置信息:模型采样率=%d Hz,声道数=%d,ALSA周期大小=%dn",
MODEL_SAMPLE_RATE, CHANNELS, PERIOD_SIZE);
// 1. 初始化ALSA录音(需确保返回单声道、int16_t格式)
if (init_alsa() != 0) {
fprintf(stderr, "初始化ALSA失败!n");
running = 0;
}
// 2. 初始化重采样器(依赖ALSA的实际采样率,必须在ALSA之后)
if (init_resampler() != 0) {
fprintf(stderr, "初始化重采样器失败!n");
running = 0;
}
// 3. 初始化sherpa-onnx模型(需确保g_asr_recognizer和g_asr_stream被正确赋值)
if (init_sherpa_asr() != 0) {
fprintf(stderr, "初始化语音识别模型失败!n");
running = 0;
}
// 4. 分配ALSA录音缓冲区(int16_t格式、单声道,PERIOD_SIZE帧)
int16_t alsa_buf = (int16_t )malloc(PERIOD_SIZE CHANNELS sizeof(int16_t));
if (alsa_buf == NULL) {
fprintf(stderr, "[ERROR] 分配ALSA录音缓冲区失败(内存不足)n");
running = 0;
}
// 5. 主循环:录音→重采样→ASR识别
printf("开始录音识别(按Ctrl+C退出)...n");
while (running) {
// 5.1 从ALSA读取音频(int16_t格式)
snd_pcm_sframes_t read_frames = snd_pcm_readi(g_pcm_handle, alsa_buf, PERIOD_SIZE);
if (read_frames < 0) {
fprintf(stderr, "[ERROR] ALSA读取失败: %sn", snd_strerror(read_frames));
if (read_frames == -EPIPE) { // 缓冲区过载,重置PCM设备
snd_pcm_prepare(g_pcm_handle);
continue;
}
break; // 严重错误,退出循环
}
if (read_frames == 0) {
// fprintf(stderr, "[WARNING] ALSA未读取到数据n");
continue;
}
// 5.2 重采样:int16_t→float(归一化+采样率转换)
float *model_audio = NULL;
int model_frames = 0;
if (resample_audio(alsa_buf, (int)read_frames, &model_audio, &model_frames) != 0) {
fprintf(stderr, "[WARNING] 重采样失败,跳过当前帧n");
continue;
}
if (model_frames == 0) {
continue;
}
// 5.3 提交音频数据到ASR流(采样率必须是模型要求的MODEL_SAMPLE_RATE)
SherpaOnnxOnlineStreamAcceptWaveform(
g_asr_stream,
MODEL_SAMPLE_RATE, // 统一使用模型采样率,避免歧义
model_audio,
model_frames * CHANNELS // 注意:此处需传入样本数(帧数×声道数)
);
// 5.4 解码音频流(有可用数据时解码)
while (SherpaOnnxIsOnlineStreamReady(g_asr_recognizer, g_asr_stream)) {
SherpaOnnxDecodeOnlineStream(g_asr_recognizer, g_asr_stream);
}
// 5.5 获取识别结果并判断端点
const SherpaOnnxOnlineRecognizerResult *result = SherpaOnnxGetOnlineStreamResult(g_asr_recognizer, g_asr_stream);
if (SherpaOnnxOnlineStreamIsEndpoint(g_asr_recognizer, g_asr_stream)) {
// 检测到语音结束,输出识别结果
if (result && strlen(result->text) > 0) {
printf("n【识别结果】: %sn", result->text);
} else {
; // printf("n【识别结果】: 未识别到有效语音n");
}
// 重置流,准备下一段语音
SherpaOnnxOnlineStreamReset(g_asr_recognizer, g_asr_stream);
}
// 5.6 释放结果内存(避免内存泄漏)
if (result) {
SherpaOnnxDestroyOnlineRecognizerResult(result);
}
}
// 6. 资源清理(逆序初始化顺序)
free(alsa_buf);
cleanup_sherpa_asr();
cleanup_resampler();
cleanup_alsa();
printf("=== 语音识别系统退出 ===n");
return 0;
}
1. 编译器指定(嵌入式开发板默认gcc,交叉编译需改为aarch64-linux-gnu-gcc)
CC = gcc
TARGET = main # 可执行文件名
SRCS = main.c alsa.c sherpa-asr.c mysamplerate.c # 源文件列表
OBJS = $(SRCS:.c=.o) # 目标文件列表(自动将.c转为.o)
2. 编译选项:-I指定头文件路径(需根据实际Sherpa-ONNX路径修改!)
CFLAGS = -Wall -g -I/root/shepa/.../sherpa-onnx-v1.12.17-linux-aarch64-jni/include
3. 链接选项:-L指定库路径,-l链接依赖库(需根据实际路径修改!)
LIBS = -lasound -lonnxruntime -lsherpa-onnx-c-api \
-L/root/shepa/.../sherpa-onnx-v1.12.17-linux-aarch64-shared-cpu/lib \
-lsamplerate
4. 生成可执行文件规则
$(TARGET): $(OBJS)
$(CC) -o $(TARGET) $(OBJS) $(LIBS)
rm -f $(OBJS) # 编译后删除.o文件,减少冗余
5. 生成.o目标文件规则
%.o: %.c
$(CC) -c -o $@ $< $(CFLAGS)
6. 清理规则:删除.o文件和可执行文件
clean:
rm -f $(OBJS) $(TARGET)
至此,我们就完成了 使用C语言 调用框架运行模型。后面的关键词识别和语音合成同理。 可以去github参考示例文件来编写程序。 关键词识别:sherpa-onnx/c-api-examples/kws-c-api.c at master · k2-fsa/sherpa-onnx 语音合成:sherpa-onnx/c-api-examples/offline-tts-c-api.c at master · k2-fsa/sherpa-onnx 思路是:先关键词唤醒,然后等待语音识别,如果识别成功则继续切换到关键词唤醒。 后续会对识别的内容进行处理(可能是接入deepseek大模型?然后tts合成语音后回复)这里我不放全部代码了。(其实稍微改改我上面的代码就能用了~ 步骤和 asr 基本一样)
6. Sherpa-ONNX 模型调用kws模型(推理核心)
sherpa-kws.c
asherpa-kws.h
现在已经可以输出结果了,我这里直接选用有名管道,来作为通信的方式,与其他的程序进行通信,就不详细演示啦~~
当多个进程同时对播放设备进行操作, 会导致没有权限(已打开、无法共享)的问题。 可以设置一下 混音插件,让多个设备共享。
- 作者:L_Z_J
- 链接:https://www.mcoi.top/article/Post-KickPi2B-Sherpa-ONNX
- 声明:本文采用 CC BY-NC-SA 4.0 许可协议,转载请注明出处。